주요 개념

  • 편차 (Deviation): 데이터값과 평균 간의 차이. 데이터가 평균에 가까울수록 ‘편차’는 작아지고 평균과 멀어질수록 커짐. ( xi​−μ ), xi = 데이터값, μ = 모집단 평균.
  • 분산 (Variance): 데이터가 평균으로부터 떨어진 정도를 숫자로 나타낸 값. 각 데이터의 ‘편차’를 제곱한 뒤 이들의 평균을 계산. 데이터가 평균에 가까울수록 편차가 작아지므로 ‘분산’도 작아지고, 평균과 멀어질수록 편차가 커지고 ‘분산’ 또한 증가하게 됨. σ2=N∑(xi​−μ)2​. 데이터가 좁은 범위에 몰려 있으면 해당 값이 작고, 데이터가 넓은 범위에 퍼져 있으면 큼.
  • 표준편차 (Standard Deviation): 분산의 양의 제곱근. σ=N∑(xi​−μ)2​​. 분산과 달리 원 데이터와 같은 단위로 표현 가능.


이해의 흐름: ‘편차’ → ‘분산’ → ‘표준편차’

  • ‘분산’은 데이터의 퍼짐 정도를 나타내기 위해 활용되는데 단점이 존재합니다. 바로 ‘편차’ 값을 제곱하면서 값이 크게 증가한다는 점인 데, 이렇게 계산된 분산 값은 그 자체로는 의미를 파악하기 어려운 점이 있습니다.
  • 예를 들어 평균 결과가 80점인 시험 점수 데이터상에서 사용자가 83점을 받았다면, ‘편차’를 통해 3점 차이 나는 것은 직관적으로 이해 할 수 있습니다. 다만 ‘분산’의 경우 이 값을 제곱하며 9가 되나 해당 값은 사용자에게 아무런 의미가 없는 숫자입니다. 따라서 ‘표준편 차’ 계산 과정을 통해, 분산 값에 루트를 적용하며 제곱으로 증가하였었던 값을 다시 맞추는 과정을 통해 ‘분산’ 9에 대한 ‘표준편차’ 값 3 을 도출할 수 있습니다. 해당 3은 평균으로부터 ‘3점’ 차이 난다는 것으로 해석할 수 있습니다.


정확도와 정밀도의 차이
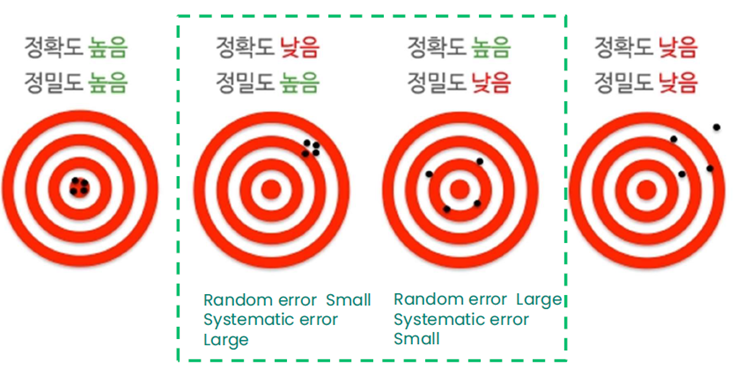
정확도와 정밀도의 차이


  • 정확도 (Accuracy): 전체 예측 중 실제 값과 유사하게 예측된 비율을 의미하며 “전체적으로 얼마나 맞았는가?”를 측정합니다.
  • 정밀도 (Precision): 여러 번 측정하거나 계산할 때 그 결과가 서로 얼마큼 가까운지를 나타내는 기준입니다. 관측의 균질성을 표 현하며 ‘편차’가 적을수록 정밀하다고 할 수 있습니다.


주요 개념

  • 기초 통계량 (Descriptive Statistics): 데이터의 가장 기본적인 특성을 요약하고 설명하기 위한 지표들의 묶음. 한 FC의 물동량과 인원수를 알면 그 규모를 상상할 수 있듯이, 기초 통계량은 데이터의 전체 모습을 상상할 수 있도록 정보를 제공.
  • 탐색적 데이터 분석 (Exploratory Data Analysis; EDA): 데이터 과학과 통계학을 활용한 심층 분석에 앞서 Raw 데이터에 대한 탐색과 이해를 진행 하는 과정.


기초 통계량

  • 평균 (Mean): 모든 데이터 값의 합을 데이터 수로 나눈 값 (=산술 평균). 데이터의 중심 경향성을 지닌 ‘평균’ 값만으로도 많은 정보를 알 수 있음. e.g. 일용직 근로자의 주간 평균 출근일 수.
  • 분산 (Variance): 데이터가 평균으로부터 떨어진 정도를 숫자로 나타낸 값. 각 데이터 값과 평균 지점 사이의 거리를 제곱한 평균. 높은 ‘분산’은 데이터가 평균에서 더 벗어나 있는 것을 의미함.
  • 표준편차 (Standard Deviation): 데이터가 평균으로 떨어진 정도를 표준화한 측정값. ‘분산’의 양의 제곱근으로서 분산보다 더 일반적으로 사용됨. 범위 (Range): 최대값과 최소값 간의 차이. 데이터의 전반적인 흩어짐을 파악할 수 있는 값. 다만 극단치가 존재하는 경우 해당 ‘범위’가 커지므로, 이러한 단점을 보완하기 위해 사분위 범위(IQR)를 사용하게 됨.
  • 사분위 범위 (Inter-Quartile Range; IQR): 데이터를 작은 값부터 큰 값까지 순서대로 나열한 뒤 25% 지점을 의미하는 1사분위수와 75% 지점을 의 미하는 3사분위수 사이의 간격. 데이터 안에 담긴 값의 절반은 해당 구간에 있어 ‘사분위 범위’ 값을 알면 데이터의 요약이 가능함.
  • 다섯 가지 요약 수치 (Five-Number Summary)
    • 최솟값 (Min)
    • 제1사분위수 (Q1): 데이터의 25% 지점.
    • 중앙값 (Median; Q2): 데이터를 크기로 나열한 순서상의 중심 값.
    • 제3사분위수 (Q3): 데이터의 75% 지점.
    • 최댓값 (Max)
  • 사분위 수 (Quartile): 데이터에 속한 값들을 작은 값부터 큰 값 순으로 줄 세운 뒤 이들을 네 조각으로 나누는 세 개 지점에 해당하는 수. F(Q1) = 0.25, F(Q2) = 0.50, F(Q3) = 0.75.


IQR & 박스 플롯

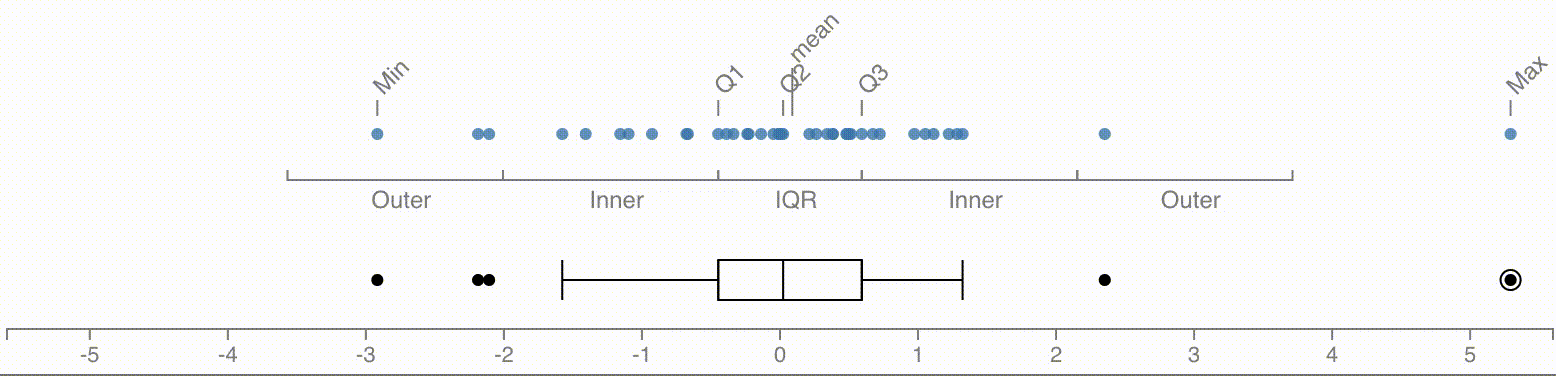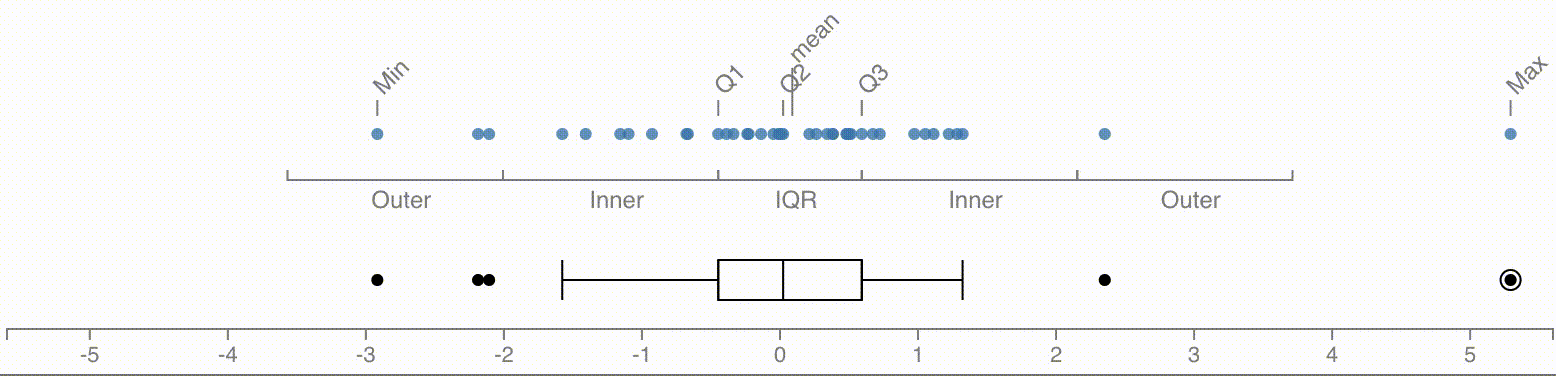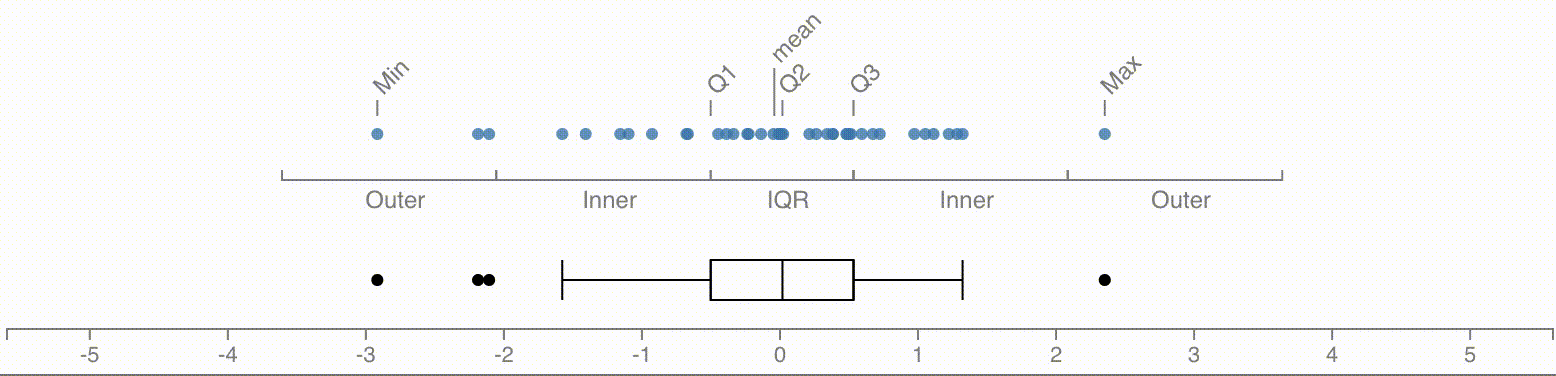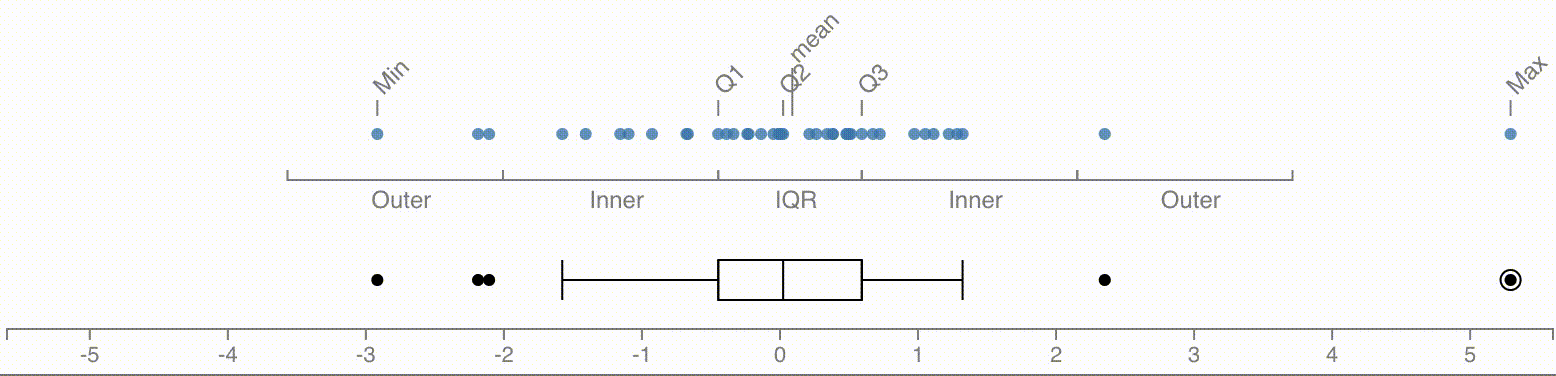
극단적으로 큰 이상값이 IQR 및 평균값에 미치는 영향

  • 박스 플롯 상 하위 경계, 내측의 최솟값 (Lower Whisker)은 Q1 – 1.5 x IQR, 최댓값 (Upper Whisker)은 Q3 + 1.5 x IQR 계산식으로 도출이 가능합니다.
  • 극단적으로 큰 값이 데이터상에 추가되었을 때 중앙값은 변하지 않지만, 평균값은 우측으로 이동하는 현상을 볼 수 있습니다. 이는 중앙값이 이상 치에 대한 높은 ‘강건성’을 가지고 있지만 평균은 낮기 때문입니다. 따라서 기초 통계량에 기반한 데이터 파악 단계에서 평균값, 중간값 둘 다 확인 해야 하는 필요가 있습니다.


주요 개념

  • 통계 (Statistics): 데이터 수집 과정의 설계, 분석 결과의 요약 및 해석, 결론까지 도출하기 위한 원칙과 방법론. 데이터를 이해하고 변동성 (Variability)와 불확실성 (Uncertainty)에 직면하여 의사결정을 내리는 응용 학문.
    • 데이터 ≠ 정보
    • 데이터 = 시그널(정보) + 노이즈
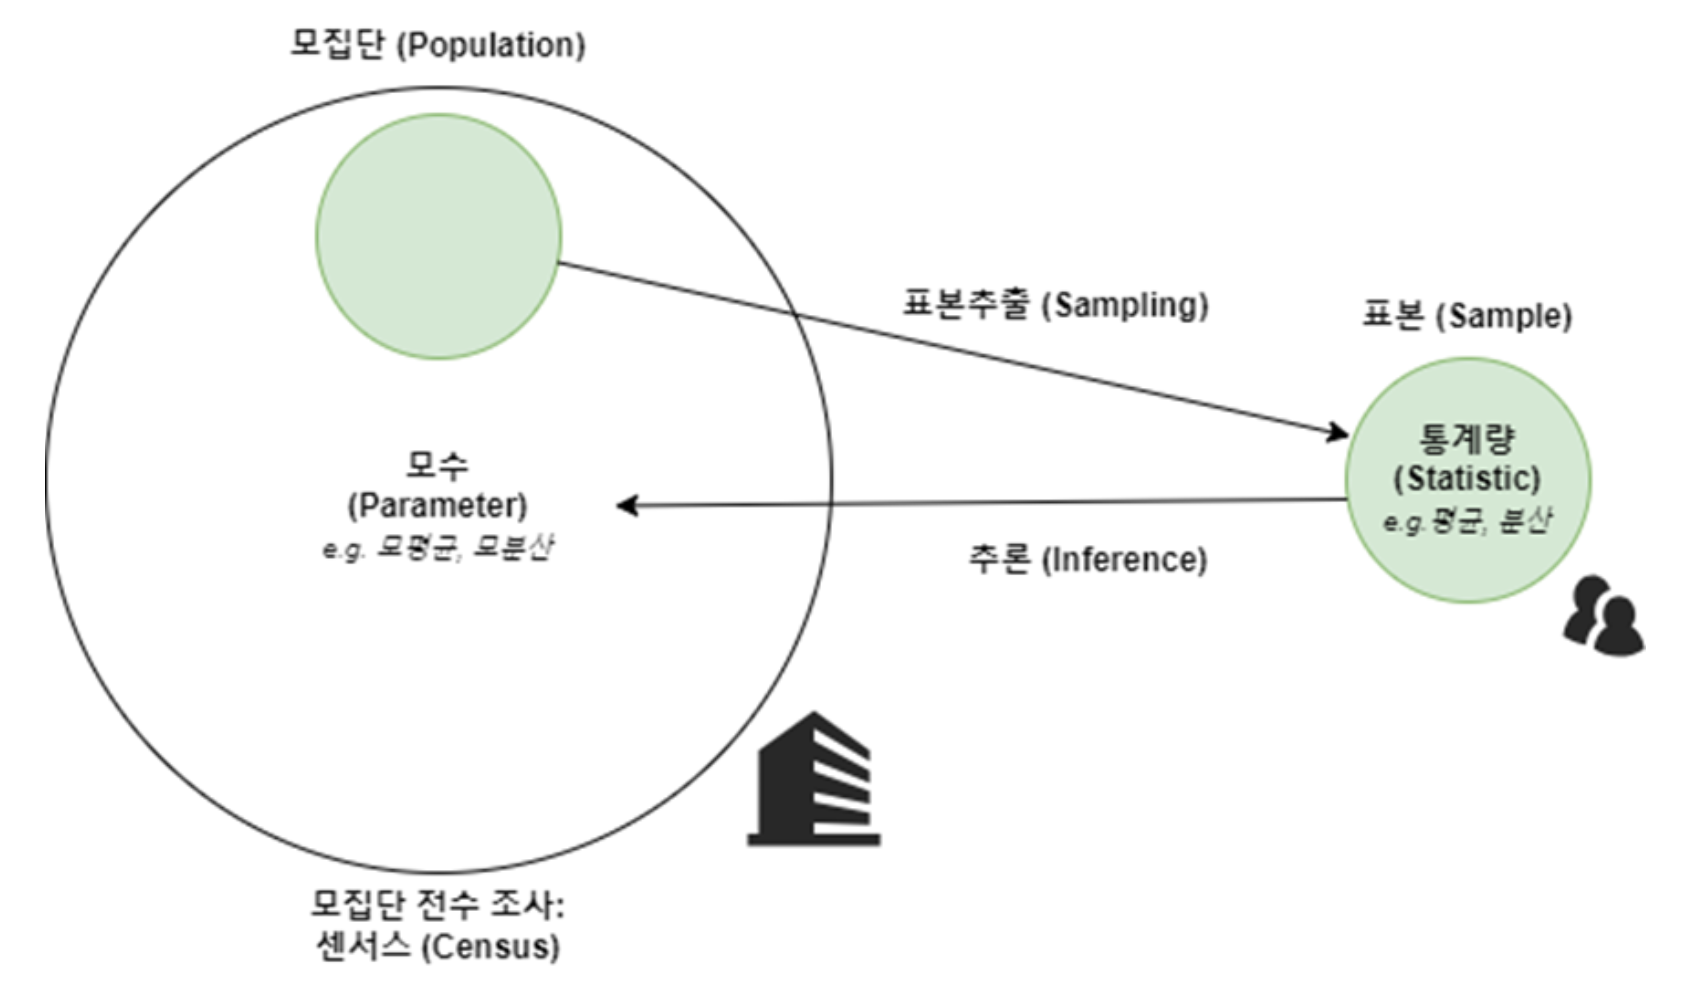
  • 모집단 (Population): 우리가 알고 싶어하는 대상이자 집단 전체. e.g. 대한민국 전체 인구, 센터 전체 근로자.
  • 표본 (Sample): 우리가 측정 또는 관찰한 결과들의 집합. 모집단의 부분 집합. e.g. 한 개 FC 센터 근로자 10명.
  • 모수 (Parameter): 모집단의 특성을 설명하는 수치. e.g. 모평균, 모분산, 모비율.
  • 통계량 (Statistic): 표본의 특성을 설명하는 수치. e.g. 표본 평균, 표본 분산, 표본 비율.


모집단과 표본과의 관계


표본추출 및 추론으로 설명 될 수 있는 모집단과 표본간의 관계


  • ‘모집단’ (Population)은 사용자가 알고 싶어하는 집단 전체를 의미합니다. 예를 들어 사용자가 대한민국 남자와 여자의 평균 키를 알고 싶다면, 모집단은 ‘대한민국 모든 남자와 여자의 키’가 됩니다. 다른 예시로, 새롭게 개발된 백신 A, B가 있을 때 이 백신 A를 처방했을때와, 백신 B를 처방했을 때 어떤 임상 효과가 있는지 알고 싶다고 한다면 모집단은 백신 A와 B를 처방했을 떄 발생한 모든 효과를 포함합니다.
  • ‘표본’ (Sample)은 모집단에 대해 추정하기 위해 선정 혹은 추출된 부분 집합입니다. 모집단의 분포가 어떻게 되어있는지 정확하게 알기 위해서는 전수조사가 필요하나 경제적으로 전수조사는 거의 불가능하고 비효율적입니다. 따라서 표본추출을 통해 모집단 전체에 대한 추정치를 대신 산출하게 됩니다. 표본자료의 평균, 분산, 분포 모양과 같은 요소를 통해 전체 모집단이 어떻게 생겼는지 추론할 수 있습니다. 앞서 언급된 예시 관련, 대한민국 모든 남자와 여자의 키를 조사하기 위해 한 학교를 선정해 조사한다면 해당 학교가 조사를 위한 표본이 됩니다. 백신 처방에 대한 효과를 분석하기 위해 실험에 참여한 인원을 임상 시험의 표본이라고 볼 수 있습니다.


기술 통계와 추론 통계의 차이


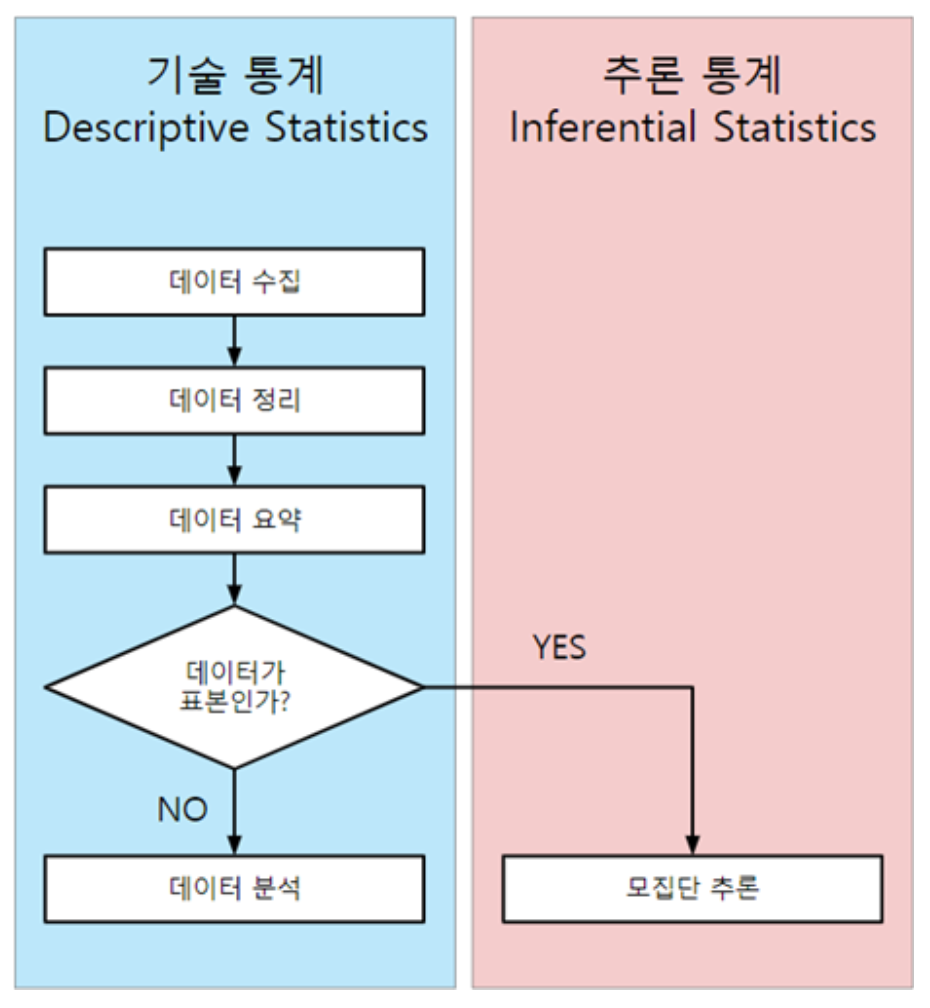
  • 통계는 데이터를 다루는 목적에 따라 ‘기술통계학’과 ‘추론 통계학’으로 나눠집니다. 평균, 중앙값, 산포도와 같은 수치로 주어진 자료를 요약하고 특성을 분석하는 것을 ‘기술통계학’ (Descriptive Statistics)이라고 합니다. 이와 반대로 주어진 자료 자체를 분석하는 것이 아닌, 표본의 평균, 중앙값, 산포도와 같은 수지 자료를 바탕으로 추출된 모집단이 어떻게 생겼는지 파악하는 것을 ‘추리 통계학’(Inferential Statistics)이라고 합니다. 모집단의 특성을 수치로 나타낸 것을 ‘모수’ (Parameter), 표본의 특성을 수치로 나타낸 것을 ‘통계량’ (Statistic)이라고 합니다.


예시: 물류센터에서 근로할 수 있는 잠재적 인원 추산

  • ‘물류센터에서 근무할 수 있는 잠재적 인구수 파악’이라는 주제를 갖고 완벽하게 조사하려면 대한민국에 거주하는 경제활동인구 (만 15세 이상 인구 중 재화나 용역을 생산하기 위해 노동을 제공할 의사와 능력이 있는 사람) 대상으로 설문을 진행하는 전수조사를 고려 할 수 있으나, 이는 현실적으로 불가능합니다. 따라서 현재 물류센터에서 근무하는 인원을 대상을 표본이라고 보고 해당 인원들에 대한 통계량을 바탕으로 대한민국에 거주하는 경제활동인구에 대한 모수를 추론하게 된다면 통계적 방식으로, 전수조사 없이 물류센터에서 근무할 수 있는 잠재적 인구수를 추론하는 과정이라고 볼 수 있습니다.
  • 해당 시나리오에서 모집단은 ‘물류센터에서 근무할 수 있는 잠재적 인구수’, 표본은 ‘현재 물류센터에서 근무하는 인원’입니다.


+ Recent posts