Statistics/기초통계
기본 통계 시리즈 - 4. 편차, 분산, 표준편차
올띵스데이터
2024. 7. 28. 22:45
주요 개념
- 편차 (Deviation): 데이터값과 평균 간의 차이. 데이터가 평균에 가까울수록 ‘편차’는 작아지고 평균과 멀어질수록 커짐. ( xi−μ ), xi = 데이터값, μ = 모집단 평균.
- 분산 (Variance): 데이터가 평균으로부터 떨어진 정도를 숫자로 나타낸 값. 각 데이터의 ‘편차’를 제곱한 뒤 이들의 평균을 계산. 데이터가 평균에 가까울수록 편차가 작아지므로 ‘분산’도 작아지고, 평균과 멀어질수록 편차가 커지고 ‘분산’ 또한 증가하게 됨. σ2=N∑(xi−μ)2. 데이터가 좁은 범위에 몰려 있으면 해당 값이 작고, 데이터가 넓은 범위에 퍼져 있으면 큼.
- 표준편차 (Standard Deviation): 분산의 양의 제곱근. σ=N∑(xi−μ)2. 분산과 달리 원 데이터와 같은 단위로 표현 가능.
이해의 흐름: ‘편차’ → ‘분산’ → ‘표준편차’
- ‘분산’은 데이터의 퍼짐 정도를 나타내기 위해 활용되는데 단점이 존재합니다. 바로 ‘편차’ 값을 제곱하면서 값이 크게 증가한다는 점인 데, 이렇게 계산된 분산 값은 그 자체로는 의미를 파악하기 어려운 점이 있습니다.
- 예를 들어 평균 결과가 80점인 시험 점수 데이터상에서 사용자가 83점을 받았다면, ‘편차’를 통해 3점 차이 나는 것은 직관적으로 이해 할 수 있습니다. 다만 ‘분산’의 경우 이 값을 제곱하며 9가 되나 해당 값은 사용자에게 아무런 의미가 없는 숫자입니다. 따라서 ‘표준편 차’ 계산 과정을 통해, 분산 값에 루트를 적용하며 제곱으로 증가하였었던 값을 다시 맞추는 과정을 통해 ‘분산’ 9에 대한 ‘표준편차’ 값 3 을 도출할 수 있습니다. 해당 3은 평균으로부터 ‘3점’ 차이 난다는 것으로 해석할 수 있습니다.
정확도와 정밀도의 차이
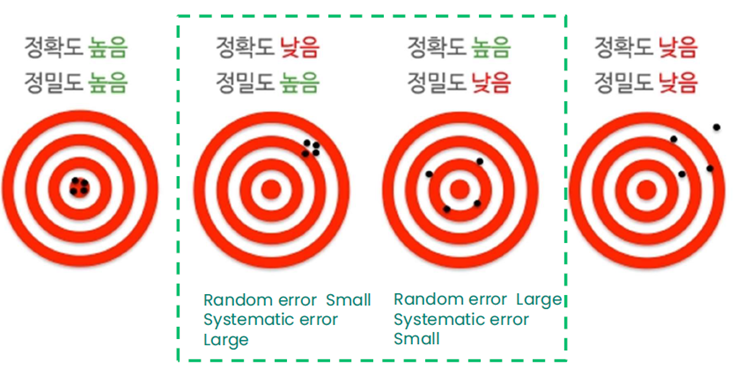
- 정확도 (Accuracy): 전체 예측 중 실제 값과 유사하게 예측된 비율을 의미하며 “전체적으로 얼마나 맞았는가?”를 측정합니다.
- 정밀도 (Precision): 여러 번 측정하거나 계산할 때 그 결과가 서로 얼마큼 가까운지를 나타내는 기준입니다. 관측의 균질성을 표 현하며 ‘편차’가 적을수록 정밀하다고 할 수 있습니다.